RAGの応答が遅い原因と対策。REFRAGの仕組みから学ぶ高速化の設計
この記事では、RAGにおける回答精度の向上と応答速度のトレードオフを解消するヒントとして、Metaが発表した技術「REFRAG」の設計思想と、実務への応用方法を解説します。
社内Q&AやカスタマーサポートなどでRAGを運用する際、回答の網羅性を上げようと検索で取得する情報を増やすと、システムの応答が極端に遅くなることがあります。精度を優先すれば待ち時間とAPI利用料がかさみ、速度を優先すれば回答の質が落ちてしまう。この板挟みに悩む現場は少なくありません。
Meta社の研究チームが2025年に発表した「REFRAG」は、この課題に一つの解決策を示しました。本番環境へすぐに導入できるものではありませんが、その設計思想は既存のシステムを見直す強力な武器になります。応答遅延の根本的な原因から、明日から試せる具体的な改善策までを紐解いていきましょう。
目次
検索と生成のジレンマを解く「REFRAG」
この章では、RAGが抱える構造的な課題と、それを解決するために提案された「REFRAG」の基本的なアプローチについて解説します。
RAGとREFRAGの定義
LLMに外部情報を検索させて回答を作るRAGは、社内情報や最新データを活用するうえで欠かせない手法です。一方で、Meta社が提案した「REFRAG(REpresentation For RAG)」は、このRAGの処理スピードを劇的に上げるための技術として注目されています。
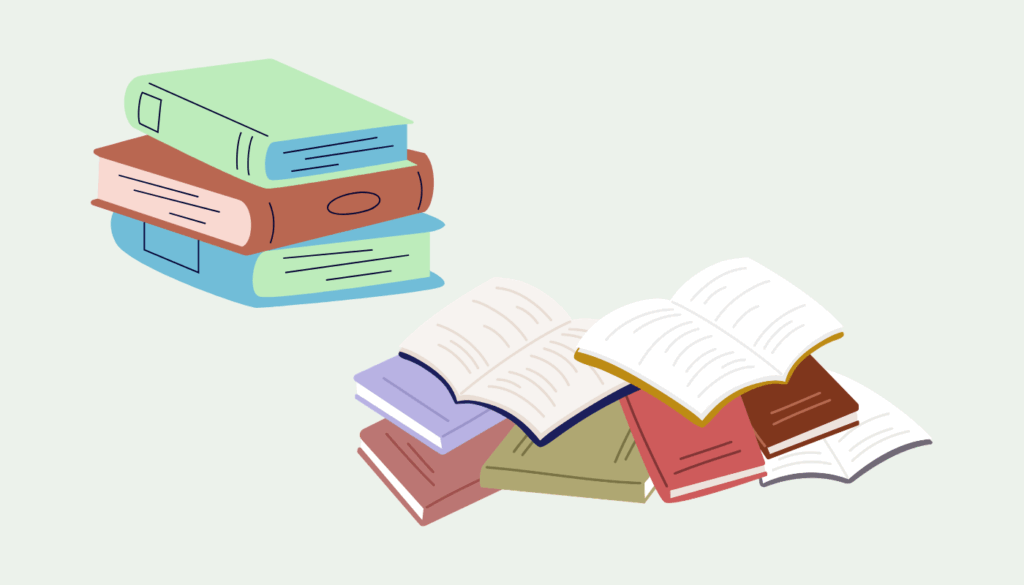
REFRAG最大の特徴は、検索してきた文章をそのままLLMに渡さず、小型のシステムで情報を「圧縮」してから渡す点にあります。これは、図書館での調べ物に似ています。
借りてきた数十冊の本をすべて端から読むと時間がかかりますが、まずは各本の目次や要約だけをざっと確認し、本当に重要な数冊だけを熟読すれば、作業ははるかに効率的になります。REFRAGは、LLMにこの賢い読み方をさせているのです。
精度を求めると速度が犠牲になるジレンマ
実務の現場では、回答の精度を上げるための施策が、そのままシステムの首を絞めることがよくあります。
たとえば、社内規程に答えるボットで「情報が足りない」というフィードバックを受け、検索してLLMに渡す文章の量(チャンク数)を5件から20件に増やしたとしましょう。たしかに回答の質は上がりますが、LLMが処理すべき文字数(トークン数)も一気に膨れ上がります。
その結果、利用者が質問を投げてから回答が表示されるまでに数秒のタイムラグが発生し、「画面が固まった」「遅くて使い物にならない」といった不満につながるのです。
応答速度とコスト増の課題を解消
REFRAGは、現場を悩ませる以下の3つの課題に対して、明確なアプローチを示しています。
- 応答速度の低下
文章を圧縮することで、最初の回答が返ってくるまでの時間を最大約30倍高速化
- 計算コストの高騰
LLMに渡すデータ量が減るため、処理にかかるメモリや利用料金を大幅に削減
- 情報量の上限
扱える文章の長さを実質16倍に広げつつ、回答の精度を維持
必要な情報を増やしても、スピードとコストは悪化させない。REFRAGは、これまでトレードオフだと諦められていた制約を突破する可能性を秘めた研究結果だといえます。
なぜRAGの応答は遅くなるのか
システムが遅延するメカニズムを正しく把握することは、改善の第一歩です。この章では、LLMの応答速度を決める指標と、内部で発生している計算の無駄について整理します。
最初の応答時間と処理能力の違い
システムの遅さを改善するには、まず「何が遅いのか」を切り分ける必要があります。LLMのパフォーマンスは、主に以下の2つの指標で評価されます。
- TTFT(Time To First Token)
最初の1トークン目が出力されるまでの待ち時間
- スループット
システム全体で、一定時間に処理できるリクエストの量
これを図書館のレファレンスデスクに例えると、TTFTは「質問をしてから、司書が最初の資料を提示し始めるまでの時間」、スループットは「1時間に何人の質問をさばけるか」に相当します。
RAGでとくに悪化しやすいのは、前者のTTFTです。LLMは回答を作り始める前に、渡された文章をすべて読み込む処理を行います。この読み込みに時間がかかるため、画面上で固まったような待ち時間が発生するのです。
メモリを圧迫する長いコンテキスト
大量の文章を読み込ませることは、処理時間だけでなく、サーバーのメモリにも大きな負担をかけます。
LLMは文章を読み込む際、計算途中のデータを「KVキャッシュ」と呼ばれる形で一時的にメモリへ保存します。LLMに渡す文章が長くなればなるほど、このキャッシュも比例して巨大化していきます。
メモリの容量には限界があるため、キャッシュが膨らむと、システムが同時に対応できる利用者の数が減ってしまいます。結果として、アクセスが集中する時間帯にスループット(処理能力)が落ち込み、全体の動作がもっさりと重くなってしまうのです。
読まれない文章にメモリを割く無駄
では、LLMは渡された文章を隅から隅まで本当に活用しているのでしょうか。Metaの研究チームが発表したREFRAGの論文では、ここに大きな無駄が潜んでいると指摘されています。
通常、RAGで検索してくる複数の文章は、それぞれ内容が異なるように選ばれます。そのため、たとえば「経費精算」のルールと「有給休暇」のルールを同時に渡した場合、LLMがこの2つを関連づけて読み解く必要はほぼありません。
しかし、従来のLLMはすべての文章の組み合わせについて関連度を計算しています。。組み合わせの数はトークン数の2乗で増えるため、入力が2倍になると計算量はおよそ4倍に膨らみます。たとえば、500トークンのパッセージを20件渡すと、組み合わせの約95%がパッセージをまたぐ計算になります。
論文によれば、こうした計算の多くはほとんど使われていないものだったのです。そこでREFRAGは、文章を圧縮して入力そのものを短くし、使われにくい計算をまとめて減らしたのです。
REFRAGが実現する3つの処理ステップ
情報をどのように圧縮し、どう活用しているのか。この章では、REFRAGが検索結果を処理する仕組みを3つの工程に分けて解説します。
以下の表は、各ステップの役割をまとめたものです。
| 段階 | 名称 | 処理の概要 | 目的 |
|---|---|---|---|
| STEP1 | 圧縮 | 文章を細かく区切り、データを小さく変換する | 読み込む情報量を大幅に減らす |
| STEP2 | 選別 | 回答への影響が大きいブロックを判定モデルが選び、原文のまま残す | 情報の欠落による回答精度の低下を防ぐ |
| STEP3 | 展開 | 圧縮データと原文を混ぜてLLMに渡す | 処理速度と回答精度を両立させて生成する |
STEP1:文章を細かく区切って圧縮
最初の工程では、検索してきた文章をさらに細かなブロックに切り分け、それぞれを小さなデータ(埋め込みベクトル)に変換します。
REFRAGは、文章を16トークンや32トークンといった短い単位で区切り、軽量な変換モデルを使ってギュッと圧縮します。たとえば、1万トークン分の検索結果も、この処理を通せばLLMにとっては数百文字分のデータ量にまでスリム化されます。
さらに、よく使われる社内マニュアルなどであれば、あらかじめこの圧縮データを計算して保存しておくことが可能です。質問が来るたびにゼロから圧縮し直す必要がないため、処理の負担を最小限に抑えられます。
STEP2:原文のまま残す重要箇所を厳選
すべてを圧縮してしまうと、細かなニュアンスや事実関係が抜け落ちてしまうリスクがあります。
たとえば、社員から「勤続6年半だと、有給休暇は何日もらえますか?」と質問されたとしましょう。社内規程には、「勤続5年6か月で18日」「勤続6年6か月以上で20日」のように、年数ごとの付与日数が並んでいます。
埋め込みは文章の大まかな意味をとらえるのは得意ですが、こうした数字の細かな違いまでは残しきれません。この部分を圧縮して渡すと、LLMは「勤続年数に応じて日数が増える」ことは理解できても、正しく「20日」と答えられない場合があります。日数や金額のように一つの数字で回答の正否が決まる箇所は、圧縮せずに原文で読ませたいところです。
そこでREFRAGは、どのブロックを原文のまま残すかを判断する専用の判定モデルを組み込んでいます。このモデルは、圧縮せずにそのまま読ませたほうが回答が正確になる箇所を自動で見抜き、重要な情報だけをピックアップする役割を担います。この判定は人がルールで決めるのではなく、強化学習で訓練されたモデルが行います。
STEP3:圧縮データと原文を混ぜて読み込む
最後の工程では、STEP1で作った「圧縮データ」と、STEP2で残した「原文」を並べてLLMに入力します。
LLMは、ユーザーからの質問とこの混ざり合ったデータを一緒に読み込み、通常通り回答を作っていきます。入力される全体のデータ量が激減しているため、読み込み時間もメモリ消費も一気に軽くなります。
論文によれば、この手法により、情報の一部を原文で残しつつも、最初の応答時間を最大で30倍近く短縮できたと報告されています。要点はざっくりと把握し、重要な部分だけを精読する。このメリハリが圧倒的なスピードを生み出しているのです。
本番環境への導入を阻む3つのハードル
画期的な技術であるREFRAGですが、明日にでも自社のシステムへ組み込めるわけではありません。この章では、導入を検討する前に知っておくべき技術的な制約を整理します。
モデル自体の再学習が不可欠
REFRAGを機能させるには、LLMそのものに「圧縮されたデータの読み方」を教え込む必要があります。
論文では、既存のLLMに対して、段階的に難易度を上げる特殊な再学習(カリキュラム学習)を行っています。この学習工程を省いてしまうと、LLMは圧縮データをうまく理解できず、的外れな回答をしてしまいます。
つまり、クラウド経由で手軽に利用できるAPI型のAIモデルでは、そもそもこの仕組みを実装できません。自社でモデルの内部構造を調整できる環境と、学習を回すための強力なサーバー設備を用意することが大前提となります。
圧縮しすぎると重要な情報が欠落する
データを小さくすればするほど速度は上がりますが、そこには明確な限界があります。
論文の実験では、圧縮の度合いを極端に高めると、かえって回答の品質が落ちてしまうことが確認されています。一度の圧縮に情報を詰め込みすぎると、どうしてもこぼれ落ちる要素が出てくるためです。
とくに、金額や日付、専門用語が密集している契約書や仕様書のようなドキュメントでは、少しの圧縮が致命的な情報の欠落につながります。対象となる文書の性質に合わせて、「どれくらいなら圧縮しても平気か」を慎重にチューニングする手間が避けられません。
非公式な実装と日本語対応の未検証
REFRAGの実装コードは、公式にはまだ完全な形で提供されているわけではありません。
オープンソースのコミュニティに有志が作成した参考プログラムは存在しますが、これらはあくまで非公式なものであり、ビジネスの基盤としてそのまま使うにはリスクが伴います。
また、論文での検証はすべて英語のデータセットで行われています。日本語の複雑な文法や、社内特有の専門用語を含んだドキュメントで同じように高い効果が出るかは未知数であり、自社のデータを使った入念な実証実験(PoC)が不可欠です。
今のRAGシステムを改善する4つの具体策
REFRAGの仕組みをそのまま導入できなくても、その「無駄を省く」という設計思想は、現在のシステムを改善するうえで大いに役立ちます。この章では、追加の学習なしで実行できる4つのアクションを紹介します。
内容が重複する検索結果を間引く
もっとも手軽で効果的なのは、検索結果の中から「同じような内容の文章」を省くことです。
REFRAGの論文も、検索結果が重複排除などによって多様化されていることを前提にしています。似た内容の文章を何件も渡しても、LLMが得られる情報はほとんど増えず、読み込むトークン数だけが増えてしまいます。
MMR(Maximal Marginal Relevance:最大限界関連性)など、検索結果の多様性を確保するアルゴリズムを間に挟み、類似度が高すぎる文章をあらかじめ除外することで、回答の質を落とさずにLLMへ渡すデータ量を削減できます。
関連度の高い文章だけを原文で渡す
REFRAGが行っている「重要箇所だけを原文で残す」アプローチを、既存の仕組みで擬似的に再現することも可能です。
検索でヒットした複数の文章をリランカーで並べ替えます。そして、上位数件だけをそのまま原文としてLLMに渡し、残りの下位の文章は、事前に生成しておいた「短い要約」に差し替えて渡すのです。
たとえば、数値や日付など、正確性が求められる情報を含む文章は、順位にかかわらず原文のまま渡すルールを設けておくと、回答の精度をより安定させることができます。
共通する部分はキャッシュで使い回す
API型のモデルではREFRAG自体を実装できませんが、似た考え方の仕組みは利用できます。それが、主要なAPI提供各社が用意している「プロンプトキャッシュ」機能です。
システムプロンプトや回答ルールなど、どの質問でも共通する内容は、プロンプトの先頭にまとめて置きます。すると2回目以降のリクエストでは、その部分の計算結果が再利用されます。読み込み処理の一部を省けるため、TTFTとAPI料金の両方を抑えられるのです。これは、REFRAGがよく使う文書の圧縮データを事前に計算しておく考え方に近いといえるでしょう。
ただし、キャッシュが効くのは、プロンプトの先頭から一致している部分に限られます。質問ごとに入れ替わる検索結果には、効果がありません。そのため、共通部分を先頭に、検索結果を後ろに配置する並び順が重要です。また、キャッシュには保持期間があるため、利用頻度の低いシステムでは効果が出にくい点にも注意しましょう。
速度とコストを評価基準に組み込む
RAGの改善を行う際は、「回答が正しいか」という精度の指標だけでなく、速度とコストも一緒に監視する体制を作りましょう。
精度ばかりを追い求めて検索件数を増やすと、いつの間にかシステムが重くなり、ユーザーが離れてしまいます。最初の応答時間(TTFT)や、入力するデータ量、1回あたりのAPI料金を同じダッシュボードで管理することが重要です。
特にTTFTは、「遅かった上位5%の平均値」などを見ることで、ユーザーが実際に感じるストレスをより正確に把握できます。「精度が1%上がる代わりに、待ち時間が2秒増える」といった事実を数値化できれば、施策を採用すべきかどうかの的確な判断を下せます。
設計の見直しがもたらす効果
REFRAGの思想を取り入れて改善策を実行した場合、システムは以下のように変化します。
| 項目 | 改善前 (チャンクを単純に増やした状態) |
改善後 (思想を取り入れた状態) |
|---|---|---|
| 入力データ量 | 重複情報も含め、すべて原文で渡すため膨大 | 重複を排除し、一部を要約にすることで大幅減 |
| 応答速度 | 読み込みに時間がかかり、待ち時間が発生 | データが軽くなり、スムーズに応答が始まる |
| コスト | APIの利用料金やサーバー負荷が増大 | 処理が効率化され、運用コストを適正に保てる |
| 意思決定 | 「なんとなく」でパラメータを調整 | 速度と精度の数値を比較し、論理的に判断可能 |
単に検索結果を増やすのではなく、「何を細かく読ませ、何を省くか」を意図的にコントロールする。これこそが、限られたリソースで最高のパフォーマンスを引き出すための鍵となります。
次のRAG改善に向けたアクション
RAGの回答精度を上げようとする試みは、常に「処理速度の低下」と「コストの高騰」という壁にぶつかります。REFRAGが示した「すべてを同じ細かさで読ませない」という割り切りのアプローチは、この壁を突破するための重要な羅針盤となります。
- 高速化を実現するREFRAGの仕組み
検索結果を小さなデータに圧縮し、重要な箇所だけを原文で残してLLMに渡すことで、初期応答時間を劇的に短縮する技術です
- 遅延を引き起こすコンテキストの肥大化
LLMに長文を読ませると、最初の回答が出るまでの時間(TTFT)が延び、メモリ消費も増大してシステム全体の処理能力が落ちます
- 既存システムに活かせる無駄の削減
内容が重複する検索結果の除外や、優先度の低い情報の一部要約化、共通するプロンプトのキャッシュなど、すぐに実践できる工夫でデータ量をスリム化できます
- 運用フェーズで必須となる多角的な評価
回答の正答率だけでなく、応答時間やAPIコストを定点観測することで、精度と速度の最適なバランスを見極めることが可能になります
高度な最新技術をそのまま導入できなくても、その裏側にある「設計の哲学」を借りることは今日からでも可能です。まずは自社のシステムで応答時間を計測し、本当にすべての文章を読ませる必要があるのか、見直すところから始めてみてください。
関連記事:
RAGとは?AIの検索精度を高める注目技術をわかりやすく解説
RAGの精度を向上させるには?最新手法と導入のポイントをやさしく解説
【RAGとファインチューニングの違いを徹底解説】最適なLLM構築戦略とは?
RAGOpsとは?PoCの壁を越え、RAGの本番運用を成功に導く設計思想
(文 = 広報室 渡邉)